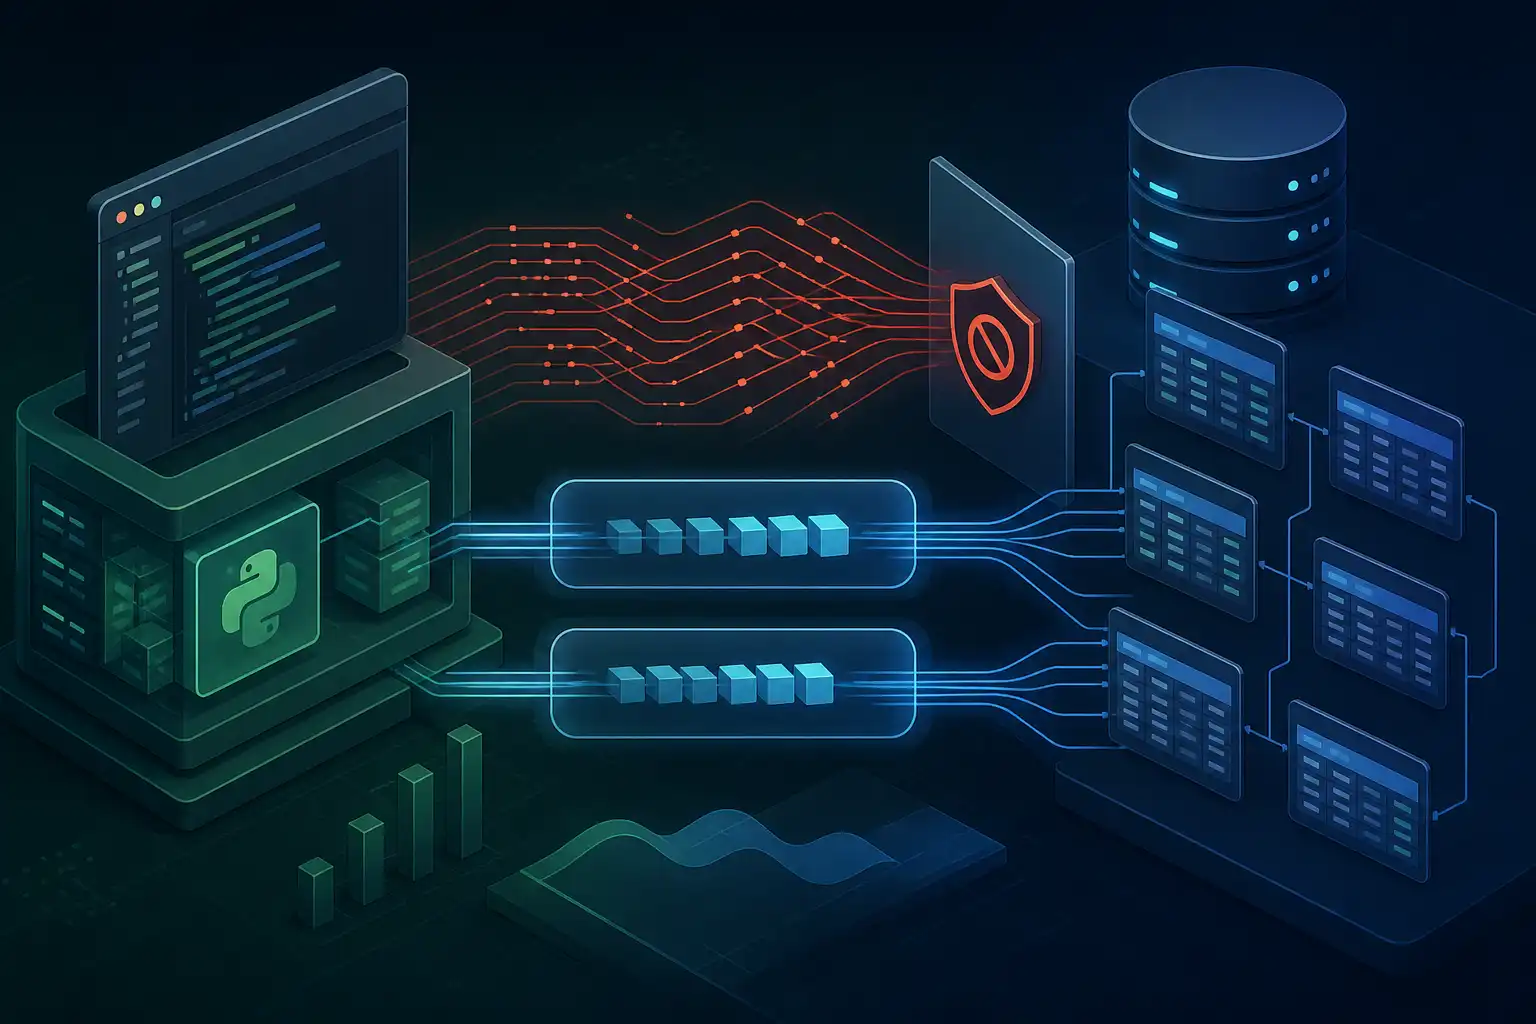
Ein ausgewertetes Book.objects.all() kann alle Bücher mit einer SQL-Abfrage laden und beim späteren Zugriff auf book.author trotzdem für jedes Objekt eine weitere Abfrage senden. Im Python-Code wirkt der Relationszugriff wie ein normaler Attributzugriff. Im Query-Log folgt jedoch SQL. Für performancekritische Listen ist FETCH_RAISE die wertvollere Neuerung in Django 6.1: Der Fehler markiert den ungeplanten Datenbankzugriff direkt im Stacktrace, während eine Laufzeitmessung nur die spätere Wirkung zeigt.
Warum Django N+1 Queries weiterhin relevant sind
Zwei kleine Modelle reichen aus, um das N+1-Muster zu reproduzieren. Jedes Buch verweist über einen ForeignKey auf einen Autor. Die Beispieldatenbank enthält 100 Bücher mit jeweils einem eigenen Autor.
from django.db import models

class Author(models.Model):
    name = models.CharField(max_length=200)

class Book(models.Model):
    title = models.CharField(max_length=200)
    author = models.ForeignKey(
        Author,
        related_name="books",
    )
Die erste Zeile des folgenden Beispiels sendet eine Abfrage für die Bücher. Jeder anschließende Zugriff auf book.author lädt den zugehörigen Autor separat, weil die Relation nicht vorab geladen wurde.
books = list(Book.objects.all())
author_names = [book.author.name for book in books]
Query-Zahl des Beispiels
Eine Abfrage lädt die Bücher, 100 weitere Abfragen laden die Autoren. Die daraus folgenden 101 Abfragen sind ein Zählbeispiel für 100 Objekte und kein Laufzeit-Benchmark. Die Netzwerk-Latenz, die Datenmenge, der Datenbank-Cache und die Ausführungspläne bestimmen die gemessene Dauer.
Django 6.1 steuert dieses implizite Nachladen mit drei Fetch Modes.
Wie die drei Fetch Modes in Django 6.1 arbeiten
Die Einstellung sitzt am QuerySet. Die daraus erzeugten Modellinstanzen übernehmen den Modus und speichern, welche anderen Instanzen als Peers aus demselben QuerySet stammen.
FETCH_ONE behält das bisherige Verhalten bei
Ohne einen expliziten Aufruf von fetch_mode() verwendet Django FETCH_ONE. Ein Zugriff auf ein fehlendes Feld oder eine ungeladene Relation löst nur für die betreffende Modellinstanz eine Datenbankabfrage aus. Bei einer Schleife über N Bücher entsteht dadurch weiterhin das Muster 1 + N.
FETCH_PEERS lädt Daten für zusammengehörige Objekte
Die Instanzen desselben QuerySets bilden eine Peer-Gruppe. Sobald der Code bei einem Objekt auf fehlende Daten zugreift, lädt Django diese Daten gebündelt für die übrigen Peer-Objekte. Weitere Zugriffe auf dieselbe Relation benötigen dann keine einzelne Abfrage pro Objekt.
FETCH_RAISE verbietet implizite Abfragen
Bei einem ungeplanten Zugriff sendet Django keine SQL-Abfrage. Stattdessen löst das ORM FieldFetchBlocked aus. Der Stacktrace zeigt die Stelle, an der ein Template, ein Serializer oder ein Service auf nicht vorab geladene Daten zugreift.
from django.db.models import FETCH_ONE, FETCH_PEERS, FETCH_RAISE

books_default = Book.objects.fetch_mode(FETCH_ONE)
books_batched = Book.objects.fetch_mode(FETCH_PEERS)
books_guarded = Book.objects.fetch_mode(FETCH_RAISE)
Die Modi verändern keine globale Django-Einstellung. Ihre Wirkung bleibt an die Instanzen des jeweiligen QuerySets gebunden. Das folgende Beispiel zeigt die Konsequenz für FETCH_PEERS.
Django 6.1 FETCH_PEERS reduziert 1 + N auf zwei Abfragen
Nach der Auswertung gehören alle erzeugten Book-Instanzen derselben Peer-Gruppe an. Der Fetch Mode wird vor der Auswertung am QuerySet gesetzt.
from django.db.models import FETCH_PEERS

books = list(
    Book.objects.fetch_mode(FETCH_PEERS)
)

first_author = books[0].author
author_names = [book.author.name for book in books]
Die Auswertung des QuerySets erzeugt die erste SQL-Abfrage für alle Bücher. Beim Zugriff auf den Autor des ersten Buchs sammelt Django die benötigten Autorenschlüssel der Peer-Objekte und lädt die entsprechenden Autoren mit einer zweiten Abfrage. Die folgende List Comprehension verwendet die bereits zugewiesenen Relationsobjekte.
Für dieses Beispiel sinkt die Query-Zahl von 101 unter FETCH_ONE auf zwei unter FETCH_PEERS. Bei mehreren später verwendeten Relationen kann pro Relation eine weitere gebündelte Abfrage entstehen. Der Modus eignet sich daher für bedingte Zugriffspfade, bei denen erst nach der ursprünglichen Abfrage feststeht, welche Relation gebraucht wird.
Wo keine implizite Datenbankabfrage zulässig ist, ersetzt FETCH_RAISE das nachträgliche Bündeln durch eine feste Grenze.
Django FETCH_RAISE als Grenze gegen versteckte Queries
Eine ungeladene ForeignKey-Relation reicht aus, um FieldFetchBlocked auszulösen. Dasselbe Verhalten betrifft Felder, die durch only() oder defer() zurückgestellt wurden.
from django.core.exceptions import FieldFetchBlocked
from django.db.models import FETCH_RAISE

books = list(Book.objects.fetch_mode(FETCH_RAISE))

try:
    author = books[0].author
except FieldFetchBlocked:
    # Die Relation wurde nicht per Eager Loading bereitgestellt.
    raise
Der Fehler legt die fehlende Eager-Loading-Entscheidung während der Entwicklung und im Test offen. Bei einem API-Listenendpunkt verhindert der Modus beispielsweise, dass ein Serializer pro Ergebnisobjekt eine zusätzliche Relation abfragt. In Templates deckt er Zugriffe auf verschachtelte Eigenschaften auf, die im View-Code nicht sichtbar waren.
Für Services mit festem Query-Budget lässt sich FETCH_RAISE mit explizitem select_related() oder prefetch_related() kombinieren. Die Relationsart und der bekannte Zugriffspfad bestimmen die Auswahl.
select_related() vs prefetch_related(), FETCH_PEERS und FETCH_RAISE
| Mechanismus | Geeigneter Zugriff | SQL-Verhalten |
|---|---|---|
| select_related() | Der Code kennt die benötigten ForeignKey- oder OneToOne-Pfade vor der Abfrage | Django lädt die Relation über SQL-Joins in derselben Abfrage |
| prefetch_related() | Der Code benötigt ManyToMany-, Reverse-ForeignKey- oder bewusst getrennte Abfragen | Django sendet geplante Zusatzabfragen und verknüpft die Ergebnisse in Python |
| FETCH_PEERS | Der Zugriff ist bedingt, die Objekte desselben QuerySets gehören jedoch zusammen | Der erste Zugriff löst eine gebündelte Abfrage für die Peer-Objekte aus |
| FETCH_RAISE | Implizite Datenbankzugriffe verletzen das festgelegte Query-Budget | Django bricht den Zugriff mit FieldFetchBlocked ab |
Django 6.1 stuft einen Aufruf von select_related() ohne explizite Relationsfelder als veraltet ein. Aus Book.objects.select_related() wird beispielsweise Book.objects.select_related("author"). Bei einem nicht vorhersehbaren Zugriff kommt FETCH_PEERS als Alternative infrage.
Das Zusammenspiel aus Python-Objektzugriffen und SQL-Ausführungsplänen wird in den Python-Schulungen sowie den Datenbank-Trainings vertieft. Für den Anwendungscode bleibt die Entscheidung unvollständig, solange kein automatisierter Test die erwartete Query-Zahl festhält.
Django-ORM-Performance mit Query-Tests absichern
TestCase.assertNumQueries() macht die erwartete Anzahl der Datenbankabfragen zu einer ausführbaren Testbedingung. Der folgende Test zählt zwei Abfragen für FETCH_PEERS. Der zweite Test bestätigt, dass FETCH_RAISE nach dem initialen Laden keine weitere Abfrage zulässt.
from django.core.exceptions import FieldFetchBlocked
from django.db.models import FETCH_PEERS, FETCH_RAISE
from django.test import TestCase

from .models import Author, Book


class BookQueryTests(TestCase):
    @classmethod
    def setUpTestData(cls):
        for number in range(3):
            author = Author.objects.create(name=f"Autor {number}")
            Book.objects.create(
                title=f"Buch {number}",
                author=author,
            )

    def test_fetch_peers_loads_authors_in_two_queries(self):
        with self.assertNumQueries(2):
            books = list(Book.objects.fetch_mode(FETCH_PEERS))
            names = [book.author.name for book in books]

        self.assertEqual(len(names), 3)

    def test_fetch_raise_blocks_author_query(self):
        with self.assertNumQueries(1):
            books = list(Book.objects.fetch_mode(FETCH_RAISE))
            with self.assertRaises(FieldFetchBlocked):
                _ = books[0].author
Ein isolierter QuerySet-Test erfasst keine späteren Zugriffe durch einen Django-REST-Framework-Serializer, einen Template-Filter oder eine Property am Modell. Ein Regressionstest sollte daher die vollständige Listenansicht aufrufen und eine verzögert gerenderte Response innerhalb von assertNumQueries() rendern. Steigt die Zahl nach einer Codeänderung, weist der fehlgeschlagene Test die zusätzliche Datenbankarbeit direkt nach.
Eine niedrigere Query-Zahl garantiert keine kürzere Laufzeit, weil große Joins mehr Daten übertragen oder ungünstige Abfragepläne erzeugen können. Query-Zahl und gemessene Laufzeit müssen deshalb getrennt erfasst werden. Vor diesen Tests stehen die technischen Voraussetzungen des Upgrades.
Projekt vor dem Upgrade auf Django 6.1 prüfen
Versionsstatus berücksichtigen
Der Beispielcode setzt den API-Stand von Django 6.1 voraus. Vor der Installation muss feststehen, ob das Projekt eine stabile 6.1-Version oder eine Vorabversion verwendet, da sich Signaturen in Vorabversionen noch ändern können.
Eine belastbare Upgrade-Prüfung deckt mehr als die Installation des Django-Pakets ab:
- Die eingesetzte Python-Version wird von der gewählten Django-Version unterstützt
- Die Version des Datenbankservers erfüllt die Mindestanforderungen dieser Django-Version
- Die verwendeten Django-Erweiterungen unterstützen Django 6.1
- Eigene Implementierungen von
Model.from_db()übernehmen den Parameterfetch_mode - Aufrufe von
select_related()enthalten explizite Relationspfade
Eigene Implementierungen von Model.from_db() müssen den neuen Parameter an die Oberklasse weiterreichen.
from django.db.models import FETCH_ONE

class Book(models.Model):
    @classmethod
    def from_db(
        cls,
        db,
        field_names,
        values,
        fetch_mode=FETCH_ONE,
    ):
        return super().from_db(
            db,
            field_names,
            values,
            fetch_mode=fetch_mode,
        )
Nach den technischen Anpassungen lässt sich das Fetch-Verhalten für jeden relevanten Query-Pfad festlegen und mit Regressionstests absichern. Die folgende Entscheidungsliste fasst die Auswahl zusammen.
Deine praktische Entscheidungsliste
- Verwende
select_related()oderprefetch_related(), wenn die benötigten Relationen vor der Abfrage feststehen - Wähle
FETCH_PEERS, wenn der Zugriff bedingt erfolgt und die Objekte desselben QuerySets gemeinsam verarbeitet werden - Setze
FETCH_RAISEein, wenn eine implizite Datenbankabfrage das Query-Budget eines Services, Serializers oder API-Endpunkts verletzt - Miss Query-Zahl und Laufzeit vor und nach der Änderung, statt aus weniger ORM-Abfragen automatisch eine kürzere Laufzeit abzuleiten
FETCH_PEERS bündelt bedarfsabhängige Relationszugriffe, während FETCH_RAISE ungeplante Zugriffe abbricht. Miss als ersten Schritt die Query-Zahl deiner wichtigsten Listenansicht unter FETCH_ONE und sichere den erwarteten Wert anschließend mit assertNumQueries().