
Zwei oder drei Schichten: die Entscheidung vor dem Switch-Kauf
Welche Netzgröße einen eigenen Core braucht, welche Redundanz Stack, StackWise Virtual und vPC liefern und warum Spine-Leaf ins Rechenzentrum gehört.
KI-generiertDieses Bild wurde mit KI erzeugt · Yves Hoppe / KI / cmt
Kurz gesagt
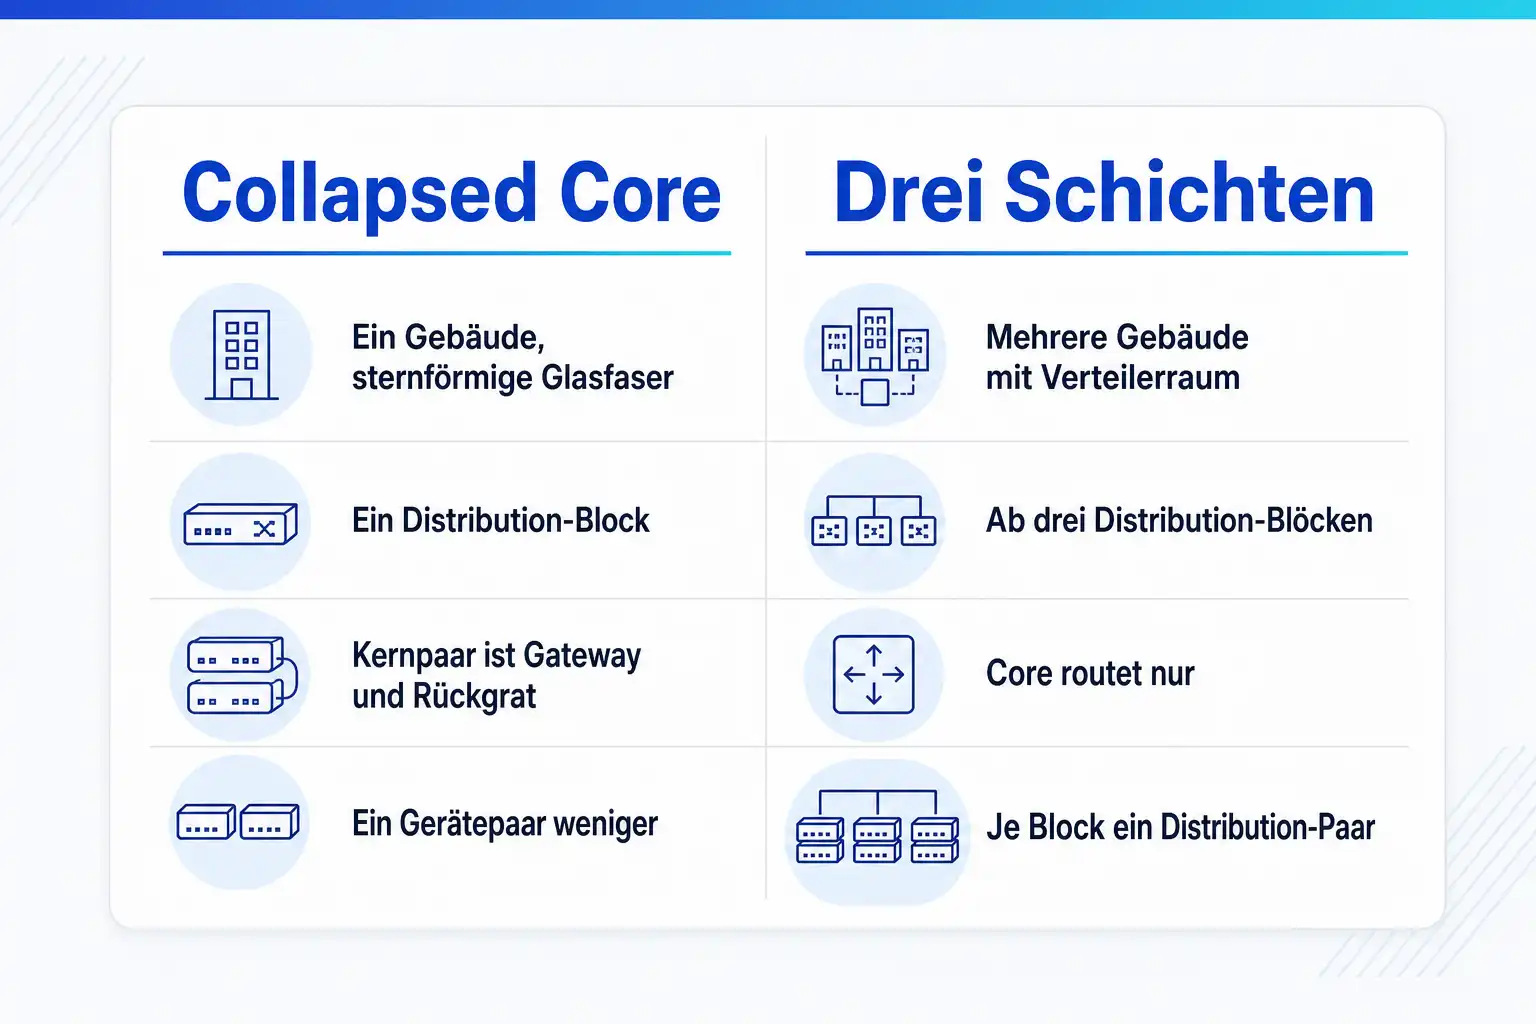
Ein Collapsed Core reicht, solange alle Etagen- und Gebäudeverteiler sternförmig an ein redundantes Kernpaar passen und es nur einen Distribution-Block gibt. Das ist bei einem Gebäude und bei kleinen Geländen mit einigen hundert bis wenigen tausend Ports die Regel. Drei Schichten brauchst du, wenn mehrere Gebäude eigene Distribution-Paare haben. Cisco empfiehlt einen eigenen Core zu prüfen, sobald mindestens drei Distribution-Blöcke verbunden werden. Spine-Leaf ist kein drittes Campus-Modell, sondern die Antwort auf Ost-West-Verkehr zwischen Servern im Rechenzentrum.
Stand dieser Seite: 25.10.2026
01 Worum es geht
Die Switch-Erneuerung ist die Gelegenheit, das Design zu ändern, und sie kommt selten
Campus-Switches laufen oft acht bis zehn Jahre. Wenn sie ersetzt werden, steht die Frage im Raum, ob das alte Design noch passt. Viele Netze im Mittelstand sind mit dem Unternehmen gewachsen. Erst gab es einen Switch im Serverraum, dann einen Stack und Etagenswitches daran. Später kam ein zweites Gebäude dazu, das per Glasfaser an einem Etagenswitch des ersten Gebäudes hängt. Das Ergebnis ist keine Architektur, sondern eine Kette.
Die Angebote der Hersteller und Systemhäuser zeigen zwei Extreme. Das eine ist ein Kernpaar, an das alles angeschlossen wird, das andere eine Hierarchie aus Access, Distribution und Core mit der doppelten Zahl an Geräten im Verteilerraum. Beides wird mit Ausfallsicherheit begründet. Wer die Entscheidung nicht an Zahlen festmacht, kauft entweder eine Schicht zu viel, die Geld und Betriebsaufwand kostet, oder eine zu wenig, die beim nächsten Gebäude einen Umbau erzwingt.
Hinzu kommen Begriffe aus dem Rechenzentrum. Spine-Leaf, VXLAN und Fabric klingen modern, und manche Ausschreibung verlangt sie für den Campus. Die Frage ist, ob die Verkehrsmuster im Büro das rechtfertigen. Diese Seite liefert die Kriterien, mit denen du das für dein Netz entscheidest.
KI-generiertDieses Bild wurde mit KI erzeugt · Yves Hoppe / KI / cmt
02 Der direkte Vergleich
Collapsed Core, drei Schichten und Spine-Leaf im direkten Vergleich
Die Matrix bewertet die drei Modelle für ein Campus-Netz, also Büro, Produktion und Gelände, nicht für ein Rechenzentrum. Gut heißt, das Modell erfüllt die Anforderung ohne Umwege; schlecht heißt, es passt nicht oder kostet unverhältnismäßig.
Collapsed Core
Zwei Schichten: Access-Switches hängen direkt an einem redundanten Kernpaar, das Distribution und Core vereint.
Drei Schichten
Access, Distribution je Gebäude oder Block und ein eigener Core, der die Distribution-Blöcke verbindet.
Spine-Leaf
Zwei Ebenen, jeder Leaf mit jedem Spine verbunden, gleich lange Wege, typisch mit VXLAN EVPN im Rechenzentrum.
| Entscheidungsfrage | Collapsed Core | Drei Schichten | Spine-Leaf |
|---|---|---|---|
| Passt es zu einem Gebäude mit einigen hundert Ports? | Stärke Das ist der Kernfall. Cisco beschreibt für ein Gebäude ausdrücklich, dass Access und Distribution ausreichen können. | Schwäche Ein eigener Core verbindet hier nur einen einzigen Distribution-Block und kostet ein Gerätepaar ohne Aufgabe. | Schwäche Die Fabric bringt bei überwiegend Nord-Süd-Verkehr keinen Vorteil und erhöht den Betriebsaufwand. |
| Trägt es ein Gelände mit vielen Gebäuden? | Kommt darauf an Solange alle Gebäudeverteiler sternförmig mit Glasfaser am Kernpaar hängen, ja. Ab mehreren eigenen Distribution-Paaren wird die Vermaschung unübersichtlich. | Stärke Jedes Gebäude bekommt einen Distribution-Block, der Core verbindet sie. Ein neues Gebäude ist ein weiterer Block, kein Umbau. | Kommt darauf an Technisch möglich, aber jeder Leaf braucht eine Verbindung zu jedem Spine, was auf einem Gelände viele Fasern über weite Strecken bedeutet. |
| Wie groß ist die Fehlerdomäne, wenn das Kernpaar ausfällt oder falsch konfiguriert wird? | Schwäche Alles hängt an einem Paar. Cisco weist darauf hin, dass Betriebs- oder Konfigurationsfehler dort das gesamte Netz betreffen können. | Stärke Ein Fehler in einem Distribution-Block bleibt in der Regel auf dieses Gebäude begrenzt, der Core routet nur und hat wenig Konfiguration. | Kommt darauf an Ein einzelner Spine fällt kaum ins Gewicht, eine fehlerhafte Fabric-Konfiguration betrifft aber alle Leafs zugleich. |
| Was kostet die Hardware im Verhältnis? | Stärke Ein Gerätepaar weniger als das Drei-Schichten-Modell, dafür müssen die Kernswitches genug Uplink-Ports für alle Access-Stacks haben. | Kommt darauf an Je Block ein Distribution-Paar plus das Core-Paar. Das lohnt sich erst, wenn die Blöcke die Ports wirklich brauchen. | Schwäche Die Vollvermaschung braucht viele Hochgeschwindigkeitsports, und für die Overlay-Funktionen fallen meist Lizenzen an. |
| Wie viel Betriebswissen setzt es voraus? | Stärke Das Modell kommt mit wenigen Geräten, einem Routing-Punkt und überschaubaren Spanning-Tree-Domänen aus. Ein kleines Team kann es betreiben. | Kommt darauf an Mehr Geräte und ein Routing-Protokoll wie OSPF zwischen Distribution und Core, das gepflegt werden muss. | Schwäche Underlay-Routing, Overlay mit VXLAN und meist BGP EVPN als Steuerprotokoll. Ohne Erfahrung mit diesen Verfahren ist die Fehlersuche langwierig. |
| Wie gut bedient es Verkehr zwischen Servern im Rechenzentrum? | Kommt darauf an Für einen kleinen Serverraum genügt es, Server hängen dann an eigenen Access-Switches am Kernpaar. | Kommt darauf an Das Modell stammt aus dem Campus. Ein Serverbereich wird als eigener Block angehängt, Wege zwischen Servern sind nicht gleich lang. | Stärke Dafür ist es gebaut: Zwischen zwei Leafs liegen immer genau ein Spine und gleich viele parallele Wege. |
Passt es zu einem Gebäude mit einigen hundert Ports?
Das ist der Kernfall. Cisco beschreibt für ein Gebäude ausdrücklich, dass Access und Distribution ausreichen können.
Ein eigener Core verbindet hier nur einen einzigen Distribution-Block und kostet ein Gerätepaar ohne Aufgabe.
Die Fabric bringt bei überwiegend Nord-Süd-Verkehr keinen Vorteil und erhöht den Betriebsaufwand.
Trägt es ein Gelände mit vielen Gebäuden?
Solange alle Gebäudeverteiler sternförmig mit Glasfaser am Kernpaar hängen, ja. Ab mehreren eigenen Distribution-Paaren wird die Vermaschung unübersichtlich.
Jedes Gebäude bekommt einen Distribution-Block, der Core verbindet sie. Ein neues Gebäude ist ein weiterer Block, kein Umbau.
Technisch möglich, aber jeder Leaf braucht eine Verbindung zu jedem Spine, was auf einem Gelände viele Fasern über weite Strecken bedeutet.
Wie groß ist die Fehlerdomäne, wenn das Kernpaar ausfällt oder falsch konfiguriert wird?
Alles hängt an einem Paar. Cisco weist darauf hin, dass Betriebs- oder Konfigurationsfehler dort das gesamte Netz betreffen können.
Ein Fehler in einem Distribution-Block bleibt in der Regel auf dieses Gebäude begrenzt, der Core routet nur und hat wenig Konfiguration.
Ein einzelner Spine fällt kaum ins Gewicht, eine fehlerhafte Fabric-Konfiguration betrifft aber alle Leafs zugleich.
Was kostet die Hardware im Verhältnis?
Ein Gerätepaar weniger als das Drei-Schichten-Modell, dafür müssen die Kernswitches genug Uplink-Ports für alle Access-Stacks haben.
Je Block ein Distribution-Paar plus das Core-Paar. Das lohnt sich erst, wenn die Blöcke die Ports wirklich brauchen.
Die Vollvermaschung braucht viele Hochgeschwindigkeitsports, und für die Overlay-Funktionen fallen meist Lizenzen an.
Wie viel Betriebswissen setzt es voraus?
Das Modell kommt mit wenigen Geräten, einem Routing-Punkt und überschaubaren Spanning-Tree-Domänen aus. Ein kleines Team kann es betreiben.
Mehr Geräte und ein Routing-Protokoll wie OSPF zwischen Distribution und Core, das gepflegt werden muss.
Underlay-Routing, Overlay mit VXLAN und meist BGP EVPN als Steuerprotokoll. Ohne Erfahrung mit diesen Verfahren ist die Fehlersuche langwierig.
Wie gut bedient es Verkehr zwischen Servern im Rechenzentrum?
Für einen kleinen Serverraum genügt es, Server hängen dann an eigenen Access-Switches am Kernpaar.
Das Modell stammt aus dem Campus. Ein Serverbereich wird als eigener Block angehängt, Wege zwischen Servern sind nicht gleich lang.
Dafür ist es gebaut: Zwischen zwei Leafs liegen immer genau ein Spine und gleich viele parallele Wege.
Was passt wann
- Ein Gebäude oder ein kleines Gelände mit einem zentralen Verteilerraum und sternförmiger Glasfaser
- Collapsed Core mit einem redundanten Kernpaar, etwa per StackWise Virtual, und Access-Stacks mit je zwei Uplinks.
- Mehrere Gebäude mit eigenem Verteilerraum, die je mehrere Etagenswitches bündeln, ab drei solchen Blöcken
- Drei Schichten mit einem Distribution-Paar je Gebäude und einem Core, der nur routet.
- Ein eigenes Rechenzentrum mit vielen Servern und Hypervisoren, die viel untereinander sprechen
- Spine-Leaf im Rechenzentrum, angebunden an den Campus über ein Border-Paar, unabhängig davon, welches Modell der Campus nutzt.
- Ein Collapsed Core, an den ein zweites Gebäude über einen Etagenswitch des ersten angehängt wurde
- Das zweite Gebäude direkt per Glasfaser an das Kernpaar führen, bevor über eine dritte Schicht nachgedacht wird.
03 Was du mitnimmst
Womit du die Designfrage beantwortest
Die Entscheidung hängt an wenigen messbaren Größen. Sechs Punkte machen sie nachvollziehbar, auch für jemanden, der das Budget freigeben muss.
Vom Ein-Gebäude-Netz zum Campus mit Core
- 01 Access: Endgeräte anschließen
- 02 Distribution: Grenze Layer 2 zu Layer 3
- 03 Collapsed Core: Distribution und Core in einem Paar
- 04 Ab drei Distribution-Blöcken: eigener Core
- 05 Rechenzentrum: Spine-Leaf für Ost-West-Verkehr
Die Aufgabe jeder Schicht benennen
Du unterscheidest Access als Anschluss der Endgeräte, Distribution als Grenze zwischen Layer 2 und Layer 3 und Core als schnelles Rückgrat zwischen Distribution-Blöcken. Wer die Aufgaben kennt, sieht, welche davon in einem Gerät zusammenfallen dürfen.
Die Zahl der Distribution-Blöcke zählen
Ein Gebäude oder ein kleines Gelände mit einem Verteilerzentrum ist ein Block, ein Gelände mit mehreren Gebäudeverteilern sind mehrere. Ab drei Blöcken empfiehlt Cisco, einen Core zu prüfen, weil sonst jeder Block mit jedem verbunden werden muss.
Uplinks und Überbuchung rechnen
Du rechnest die Summe der Access-Ports gegen die Uplink-Bandbreite und die Zahl der Uplink-Ports, die das Kernpaar bereitstellen muss. Daraus folgt, ob zwei Kernswitches physisch reichen.
Redundanzverfahren unterscheiden
Du weißt, was ein Stack, StackWise Virtual und vPC jeweils zusammenlegen und was getrennt bleibt: die Datenebene, die Steuerebene oder beides. Davon hängt ab, was ein Softwarefehler oder ein Update mit dem ganzen Paar macht.
Spine-Leaf richtig einordnen
Du erkennst, dass Spine-Leaf für Verkehr zwischen Servern gebaut ist und im Campus mit seinem Nord-Süd-Verkehr kaum Vorteile bringt. Campus-Fabrics wie Cisco SD-Access lösen andere Probleme, vor allem Segmentierung und Richtlinien.
Eine Begründung schreiben, die in fünf Jahren noch trägt
Du hältst Portzahl, Gebäude, Wachstum, Ausfallanforderung und Betriebskapazität fest und leitest das Design daraus ab. Beim nächsten Gebäude ist klar, ob es als Block angehängt wird oder einen Umbau auslöst.
KI-generiertDieses Bild wurde mit KI erzeugt · Yves Hoppe / KI / cmt
Die drei Schichten und was jede leistet
Das Drei-Schichten-Modell trennt Aufgaben, nicht Geräte. Die Access-Schicht schließt Endgeräte an, liefert Strom über PoE für Telefone, Kameras und Access Points und setzt Richtlinien am Port durch, etwa 802.1X, Port-Security oder Storm Control. Die Distribution-Schicht bündelt die Access-Switches eines Bereichs, ist die Grenze zwischen der Layer-2-Welt der VLANs und der Layer-3-Welt des Routings und fasst Routen zusammen, bevor sie weitergegeben werden. Der Core verbindet die Distribution-Blöcke und soll vor allem schnell und stabil sein.
Cisco beschreibt die Distribution ausdrücklich als Grenze zwischen der Layer-2-Domäne des Access und der Layer-3-Domäne des Cores und als logischen Punkt, um Routing-Informationen zusammenzufassen. Genau diese Aufgaben fallen beim Collapsed Core mit denen des Cores zusammen: Das Kernpaar ist dann Gateway der VLANs, Routing-Punkt und Rückgrat zugleich.
| Schicht | Aufgabe | Typische Funktionen | Typische Geräte |
|---|---|---|---|
| Access | Endgeräte anschließen | VLAN-Zuordnung, PoE, 802.1X, BPDU Guard, Storm Control | Stacks aus 48-Port-Switches im Etagenverteiler |
| Distribution | Access-Switches eines Bereichs bündeln | Gateway der VLANs, Gateway-Redundanz, Routen zusammenfassen, Filter | Paar mit vielen 10/25-Gbit-Ports |
| Core | Distribution-Blöcke verbinden | schnelles Routing, wenig Konfiguration, keine Endgeräte | Paar mit 40/100-Gbit-Ports |
| Collapsed Core | Distribution und Core in einem Paar | Gateway, Routing, Rückgrat und Anbindung von Servern, WAN und Internet | Paar mit vielen Uplink-Ports |
Collapsed Core: wann zwei Schichten reichen
Cisco nennt den Collapsed Core die Alternative für kleinere Standorte und Ein-Gebäude-Campus. Ein Standort, der ein einziges Gebäude belegt, braucht nach dieser Beschreibung womöglich nur Access und Distribution, ein Gelände mit mehreren Gebäuden höchstwahrscheinlich alle drei Schichten. Für die Grenze nennt Cisco eine Zahl: Werden mindestens drei Distribution-Blöcke verbunden, sollte ein Core in Betracht gezogen werden, und bei mehr als drei Blöcken an einem Ort sollte ihn eine Organisation einsetzen.
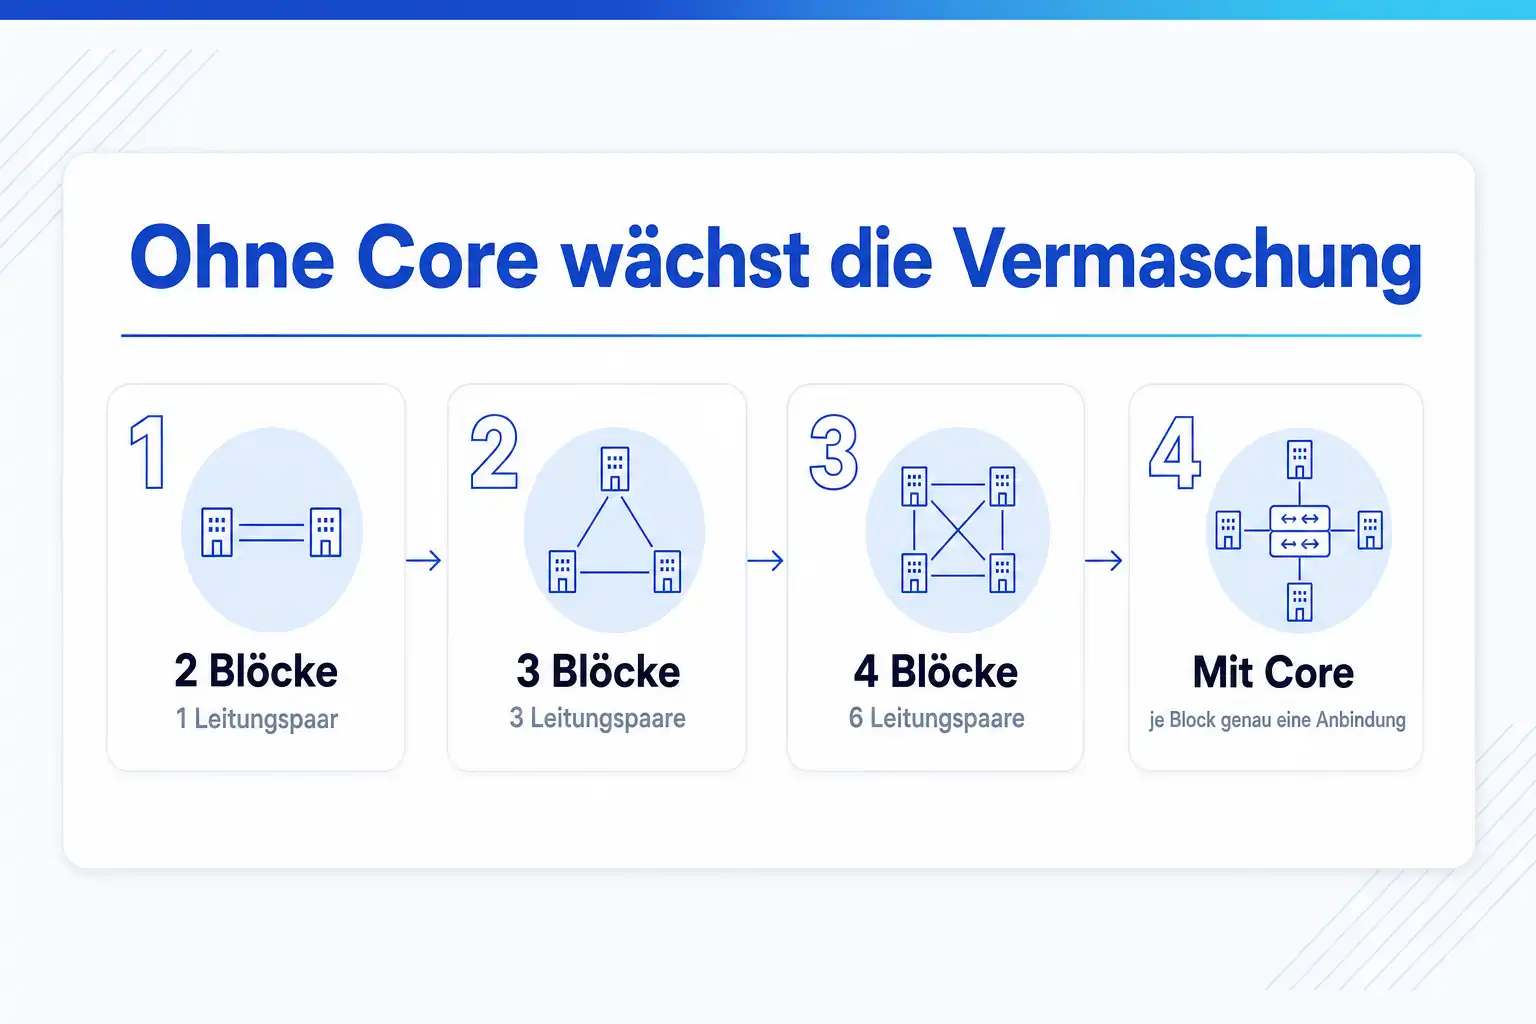
Der Grund ist die Vermaschung. Ohne Core muss jeder Distribution-Block mit jedem anderen verbunden sein, damit es keinen Umweg gibt. Bei zwei Blöcken ist das ein Leitungspaar, bei drei sind es drei Paare, bei vier sechs, allgemein n mal n minus 1 durch 2. Jede dieser Verbindungen ist eine Routing-Nachbarschaft, die gepflegt werden will. Mit einem Core hat jeder Block genau eine Anbindung, unabhängig davon, wie viele Blöcke es gibt.
Für die meisten Mittelständler mit einem Hauptgebäude, vielleicht einer Halle und einem Nebengebäude ist der Collapsed Core das passende Modell, sofern alle Gebäudeverteiler direkt per Glasfaser am Kernpaar hängen. Die Gebäudeverteiler sind dann Access-Stacks, keine eigenen Distribution-Blöcke. Das Gateway aller VLANs liegt auf dem Kernpaar.
Rechenweg: reichen zwei Kernswitches physisch?
Ob ein Collapsed Core trägt, entscheidet auch die Zahl der Ports. Jeder Access-Stack braucht mindestens zwei Uplinks, einen zu jedem Kernswitch, damit der Ausfall eines Kernswitches oder einer Faser den Stack nicht abschneidet. Cisco nennt in seinem Campus-Design als Beispiel zwei 10-Gbit-Uplinks je 48-Port-Switch und vier 10-Gbit-Uplinks für einen Stack aus zwei Switches.
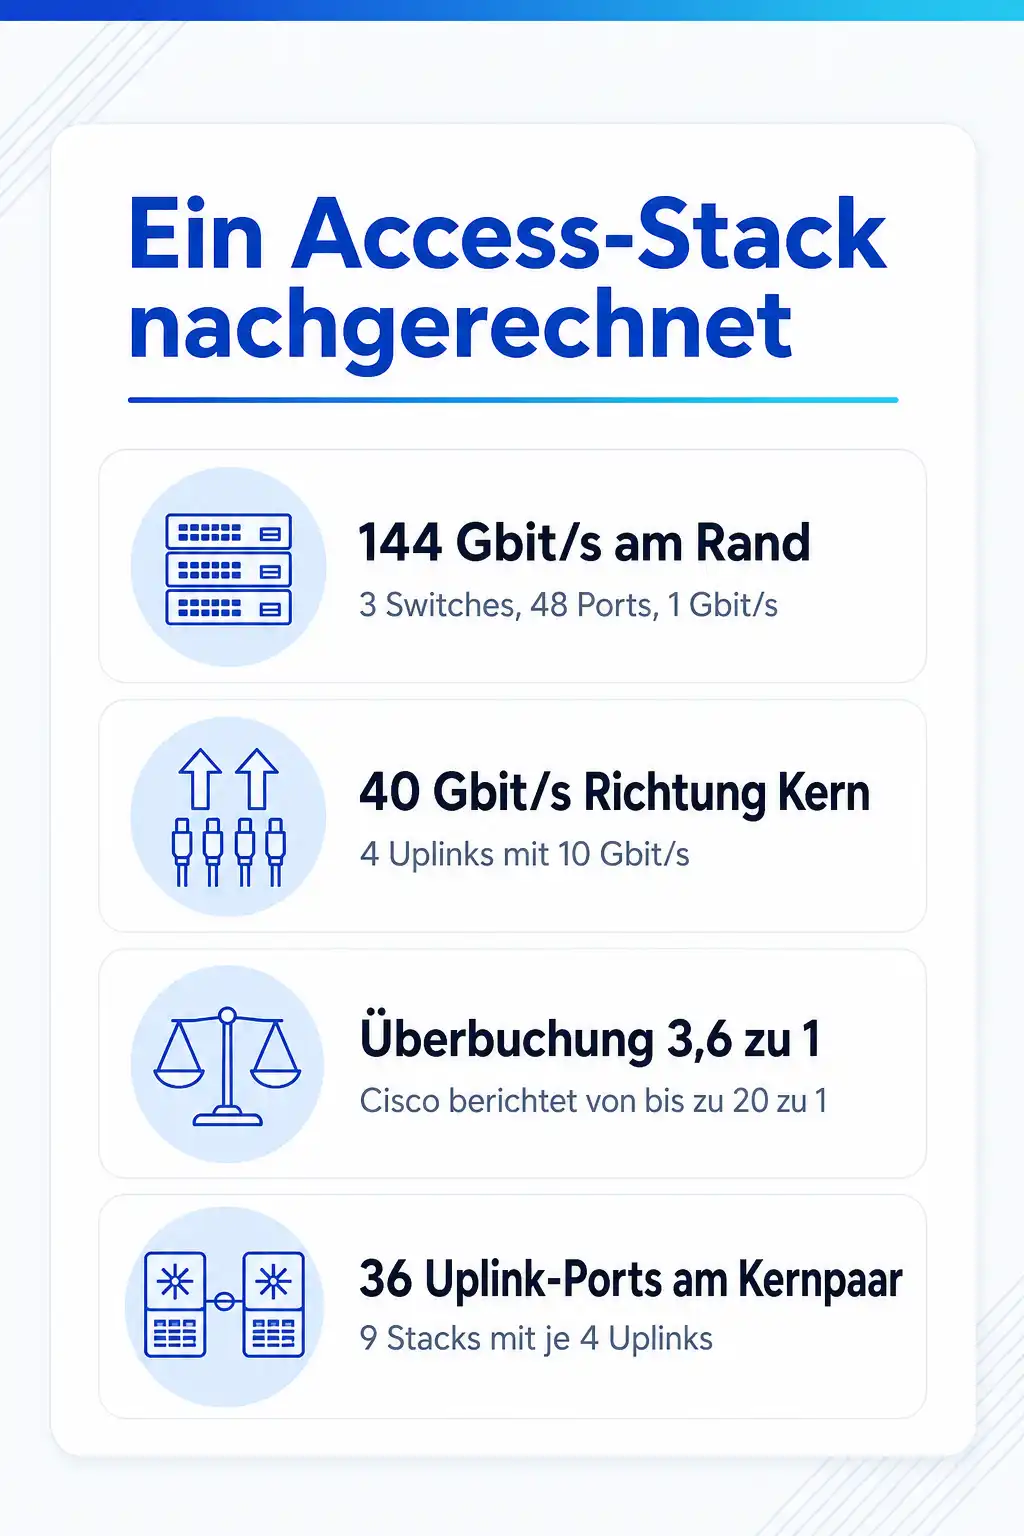
Ein Beispiel mit angenommenen Zahlen: 1200 Arbeitsplatzports in 48-Port-Switches ergeben 25 Switches, gebündelt in 9 Stacks zu meist drei Switches. Mit vier Uplinks je Stack braucht das Kernpaar 36 Ports für Access, also 18 je Switch, plus Ports für Server, Firewall, WLAN-Controller und Reserve. Ein Kernpaar mit je 48 Ports im 10/25-Gbit-Bereich hat damit genug Luft.
Die Überbuchung rechnest du je Stack. Drei 48-Port-Switches mit 1 Gbit/s ergeben 144 Gbit/s am Rand, vier Uplinks mit 10 Gbit/s ergeben 40 Gbit/s Richtung Kern, das Verhältnis ist 3,6 zu 1. Cisco berichtet von Designs mit Verhältnissen bis 20 zu 1 zwischen Access und Distribution. Büroverkehr erreicht fast nie gleichzeitig Leitungsrate auf allen Ports. Kritisch wird es bei Access Points mit Multigigabit-Ports und bei Bereichen mit großen Dateien, etwa CAD oder Video.
| Größe | Rechnung | Ergebnis |
|---|---|---|
| Access-Bandbreite je Stack | 3 Switches × 48 Ports × 1 Gbit/s | 144 Gbit/s |
| Uplink-Bandbreite je Stack | 4 Uplinks × 10 Gbit/s | 40 Gbit/s |
| Überbuchung | 144 : 40 | 3,6 zu 1 |
| Uplink-Ports am Kernpaar | 9 Stacks × 4 Uplinks | 36 Ports, 18 je Kernswitch |
| Verbindungen ohne Core bei 4 Blöcken | 4 × 3 : 2 | 6 Leitungspaare |
Redundanz: Stack, StackWise Virtual und vPC
Ein Kernpaar soll für die angeschlossenen Switches wie ein einziges Gerät wirken, damit die Uplinks eines Access-Stacks als ein EtherChannel zu beiden Kernswitches laufen können. Dann blockiert Spanning Tree keinen der Uplinks, und beide tragen Last. Cisco nennt das Multichassis EtherChannel und empfiehlt, statt fest eingeschalteter Bündel ein dynamisches Protokoll wie LACP zu nutzen.
Die drei verbreiteten Verfahren unterscheiden sich darin, was sie zusammenlegen. Ein Stack aus Catalyst 9300 verbindet bis zu acht Switches über Stack-Kabel zu einem Gerät mit einer gemeinsamen Steuerebene, einem aktiven und einem Standby-Switch. StackWise Virtual macht dasselbe mit zwei Switches über normale Ethernet-Ports. Es läuft auf Catalyst 9400, 9500 und 9600, laut Cisco nur mit Network-Advantage-Lizenz, und Cisco empfiehlt mindestens zwei physische Ports für die Verbindung. vPC auf Nexus-Switches mit NX-OS lässt zwei getrennte Steuerebenen bestehen und verbindet die Geräte über einen Peer-Link und einen separaten Keepalive.
Der Unterschied zeigt sich bei Updates und Softwarefehlern. Bei einem Stack und bei StackWise Virtual läuft auf beiden Geräten dieselbe Software unter einer Steuerebene, ein Fehler dort trifft beide. Bei vPC sind die Geräte unabhängig, jedes wird einzeln konfiguriert und aktualisiert, die Konfiguration muss aber auf beiden Seiten passen.
| Verfahren | Geräte | Steuerebene | Typischer Einsatz |
|---|---|---|---|
| Stack (StackWise-480) | bis 8 Catalyst 9300 | eine, aktiver und Standby-Switch | Access, kleiner Collapsed Core |
| StackWise Virtual | 2 Catalyst 9400, 9500 oder 9600 | eine, über Ethernet-Verbindung | Collapsed Core, Distribution, Core |
| vPC | 2 Nexus mit NX-OS | zwei getrennte, Peer-Link und Keepalive | Rechenzentrum, Server-Access |
| Zwei Einzelgeräte mit HSRP oder VRRP | 2 beliebige Layer-3-Switches | zwei getrennte | einfaches Gateway-Paar, Spanning Tree blockiert einen Uplink |
! auf beiden Catalyst 9500, danach write memory und reload
stackwise-virtual
 domain 10
interface HundredGigE1/0/49
 stackwise-virtual link 1
interface HundredGigE1/0/50
 stackwise-virtual link 1
!
! nach dem Zusammenschluss: EtherChannel zu Access-Stack 3
interface range TwentyFiveGigE1/0/3 , TwentyFiveGigE2/0/3
 channel-group 3 mode active
interface Port-channel3
 switchport mode trunk
 switchport nonegotiate
 switchport trunk allowed vlan 10,30,40,999
Routed Access: Layer 3 bis in den Etagenverteiler
Eine Variante beider Modelle verlegt die Grenze zwischen Layer 2 und Layer 3 in die Access-Schicht. Jeder Access-Stack ist dann selbst Gateway seiner VLANs und routet über seine Uplinks per OSPF oder einem anderen Routing-Protokoll zum Kern. Zwischen Access und Kern gibt es keine Trunks und kein Spanning Tree mehr, sondern geroutete Punkt-zu-Punkt-Verbindungen mit gleich teuren Wegen.
Cisco empfiehlt grundsätzlich, ein VLAN auf einen Verteilerraum oder ein Uplink-Paar zu beschränken, weil VLANs, die sich über mehrere Access-Switches ziehen, Schleifen ermöglichen und Spanning Tree Bandbreite blockieren lässt. Routed Access setzt das konsequent um. Der Preis ist, dass ein VLAN nicht mehr über mehrere Etagen reicht. Für Geräte, die beim Umzug ihre Adresse behalten sollen, oder für drahtlose Clients, die zwischen Etagen roamen, brauchst du dann eine andere Lösung, etwa ein zentrales WLAN-Gateway oder ein Overlay.
Spine-Leaf gehört ins Rechenzentrum, nicht in den Campus
Spine-Leaf wurde für Verkehr zwischen Servern entwickelt. Virtualisierung, verteilte Datenbanken und Speichercluster erzeugen viel Ost-West-Verkehr, also Verkehr zwischen Systemen im selben Rechenzentrum. In einer Spine-Leaf-Fabric ist jeder Leaf mit jedem Spine verbunden, und zwischen zwei Servern an verschiedenen Leafs liegen immer genau drei Geräte: Leaf, Spine, Leaf. Mehr Kapazität bekommst du, indem du einen Spine hinzufügst, und alle Wege werden gleichmäßig genutzt.
Im Campus fließt der meiste Verkehr in Nord-Süd-Richtung, von Clients zu Servern im Rechenzentrum, zu Cloud-Diensten oder ins Internet. Clients sprechen selten direkt miteinander. Die Stärke von Spine-Leaf, gleich lange Wege zwischen beliebigen Endpunkten, bringt dort wenig. Dafür kostet die Vollvermaschung über ein Gelände viele Fasern, und das Overlay mit VXLAN und BGP EVPN verlangt ein Betriebswissen, das viele Campus-Teams nicht haben.
Davon zu unterscheiden sind Campus-Fabrics wie Cisco SD-Access. Sie nutzen ebenfalls ein Overlay mit VXLAN, aber nicht wegen gleich langer Wege, sondern um Segmentierung und Zugriffsrichtlinien unabhängig von VLANs und IP-Adressen durchzusetzen. Das Underlay bleibt dabei ein geroutetes Netz in einer Campus-Hierarchie. Ob sich das lohnt, ist eine Frage der Richtlinien und der Betriebswerkzeuge, nicht der Schichtenzahl.
Drei Beispielbetriebe und ihr passendes Design
Die folgenden Betriebe sind konstruierte Beispiele mit typischen Größen, keine Kundenfälle. Sie zeigen, wie die Kriterien aus der Matrix zu einer Entscheidung führen.
-
Steuerkanzlei, ein Gebäude, 120 Ports, Serverraum im Keller
Ein Stack aus drei Catalyst 9300 im Serverraum dient als Collapsed Core und Access zugleich, die zwei Etagenverteiler hängen mit je zwei Uplinks daran. Eine eigene Distribution oder ein Core hätten hier keine Aufgabe. Die Firewall stellt Gateways für Gäste und Gebäudetechnik, der Stack routet die internen VLANs.
-
Maschinenbauer, drei Gebäude auf einem Gelände, 1200 Ports
Ein Kernpaar mit StackWise Virtual im Hauptgebäude bildet den Collapsed Core. Alle neun Access-Stacks, auch die in Halle und Verwaltungsbau, hängen sternförmig per Glasfaser direkt daran. Es gibt einen einzigen Distribution-Block, ein Core wäre überflüssig. Wichtig ist eine zweite, räumlich getrennte Faserstrecke zu jedem Gebäude.
-
Klinikum mit acht Gebäuden und eigenem Rechenzentrum, 6000 Ports
Jedes Gebäude hat einen eigenen Verteilerraum mit einem Distribution-Paar, an dem die Access-Stacks der Etagen hängen. Acht Blöcke liegen weit über der Schwelle, ab der Cisco einen Core empfiehlt, also verbindet ein Core-Paar die Blöcke per OSPF. Das Rechenzentrum ist als Spine-Leaf aufgebaut und über ein Border-Paar an den Core angebunden.
Dazu passende Kurse
Wer die Redundanzverfahren und Fabric-Modelle an echter Hardware vergleichen will, findet Kurse zu Catalyst, SD-Access und Nexus im Katalog.
Bevor es um Hersteller geht, hilft ein Kurs zu den Grundlagen der Netzwerkarchitektur, der Schichtenmodell, Routing und Redundanz im Zusammenhang erklärt.
04 Konkrete Kurse
Wo du genau das übst
- Implementieren von Cisco Catalyst 9000 Switches
- Grundlagen von Cisco SDA verstehen
- Netzwerktechnik Intensivkurs: Vom TCP/IP-Grundlagenwissen zur sicheren Praxis
- Implementierung von Cisco NX-OS Switches und Fabrics im Rechenzentrum
Weitere Kurse aus diesem Bereich
- Cisco IPv6 – Grundlagen, Design und Implementierung
- Anwendungsentwicklung und Workflow-Automatisierung mit Cisco Core-Plattformen
- Cisco Enterprise Wireless Netzwerke – Planung und Design
- Implementierung und Administration von Cisco Lösungen
- Implementierung von Cisco Collaboration Conferencing
- Cisco – Grundlagen von Webex Calling
- Grundlagen von Cisco Firewall Threat Defense und Intrusion Prävention (Angriffserkennung und -verhinderung)
Preise, Orte und Buchung für alle Kurse des Bereichs findest du im Katalog: Alle Netzwerktechnik-Schulungen mit Terminen.
Stimmen aus den Kursen
Was Teilnehmende über die Kurse in diesem Bereich sagen
Hervorragender Referent, der kurzweilig und sehr strukturiert durch den Kurs geführt hat und keine Fragen offen gelassen hat.
Vielen Dank, Seminar war informationsreich, verständlich, persönlich sehr angenehm.
Durch den 1 zu 1 Kurs konnten meine Fragen und Ziele optimal bearbeitet werden.
05 Fragen
Häufige Fragen
Deine Frage ist nicht dabei? Stell sie uns direkt, wir antworten dir persönlich.
Ab wie vielen Ports brauche ich einen eigenen Core?
Ist ein Collapsed Core ein Single Point of Failure?
Kann ich später von zwei auf drei Schichten wechseln?
Brauche ich für einen Collapsed Core StackWise Virtual?
Was ist der Unterschied zwischen StackWise Virtual und vPC?
Gehört die Firewall in den Core?
Passt thematisch dazu
Das Campus-Design endet am Standortrand; wie Filialen und Werke angebunden werden, beschreibt der Glossareintrag zu SD-WAN für die Anbindung von Außenstellen.
StackWise Virtual und vPC lösen dasselbe Problem wie Servercluster, und die Grundprinzipien hochverfügbarer Cluster helfen, Split-Brain und Quorum auch im Netz zu verstehen.
Quellen
- Cisco, Campus LAN and Wireless LAN Solution Design Guide (Cisco Validated Design)
- Cisco, Borderless Campus 1.0 Design Guide: Design and Deployment Models
- Cisco, High Availability Configuration Guide, IOS XE 17.15.x (Catalyst 9500): Configuring Cisco StackWise Virtual
- Cisco, Catalyst 9000 Platform StackWise Virtual White Paper
- Cisco, Stacking and High Availability Configuration Guide, IOS XE 17.3.x (Catalyst 9300): Managing Switch Stacks
- Cisco, Nexus 9000 NX-OS Interfaces Configuration Guide, Release 10.2(x): Configuring vPCs
Deine Ansprechpartner
Du bist dir nicht sicher, welcher Kurs oder welches Level zu dir passt? Wir beraten dich persönlich und kostenlos.

Yves Hoppe
Weiterbildung & Beratung
Hilft dir, aus dem Netzwerktechnik-Programm den passenden Kurs für deinen Stand zu finden.

Norbert Jansen
Beratung & Inhouse
Plant mit dir Inhouse-Trainings, die auf eure Abläufe und euren Datenbestand zugeschnitten sind.
Ein Campus-Design einmal selbst durchrechnen
In den Catalyst-, SD-Access- und Rechenzentrumskursen bei cmt lernst du Stacks, StackWise Virtual und Fabrics kennen und vergleichst ihr Verhalten bei Ausfällen, vor Ort oder Live-Online mit eigenen Trainerinnen und Trainern.
Verwandte Themen
- VLAN einrichten: vom Plan über Access- und Trunk-Ports bis zum Routing zwischen den Netzen
- Netzwerkschleife und Broadcast-Sturm: finden, stoppen und mit Spanning Tree verhindern
- Catalyst Center oder Meraki: On-Premises-Steuerung oder Cloud-Dashboard für das Cisco-Netz
- OSPF oder BGP: welches Routing-Protokoll wohin gehört